
项目仓库: https://github.com/Akvicor/nginx-healthcheck-module
已编译源: https://deb.ksyaki.com/nginx/
Nginx 自带的 upstream 失败处理主要依赖请求过程中的被动失败触发,例如连接失败、超时或上游返回错误后再调整 peer 状态。这种机制过于简单,当一个后端已经不可用时,流量可能仍然需要先打到它,Nginx 才能感知失败,而且就算后端一直不可用,一段时间后nginx也会自动将有问题的上游恢复,此时又会有用户访问到有问题的上游。
而 nginx-healthcheck-module 插件就是为了解决无法主动探测上游的问题,插件会在请求流量之外,主动周期性检查 upstream peer,并把不健康的 peer 标记为异常,并从负载均衡选择中跳过。
nginx-healthcheck-module 插件由 我 (Akvicor) 维护,修改自 yaoweibin/nginx_upstream_check_module,重点适配 Nginx 1.26+,并聚焦 TCP/UDP 健康检查。
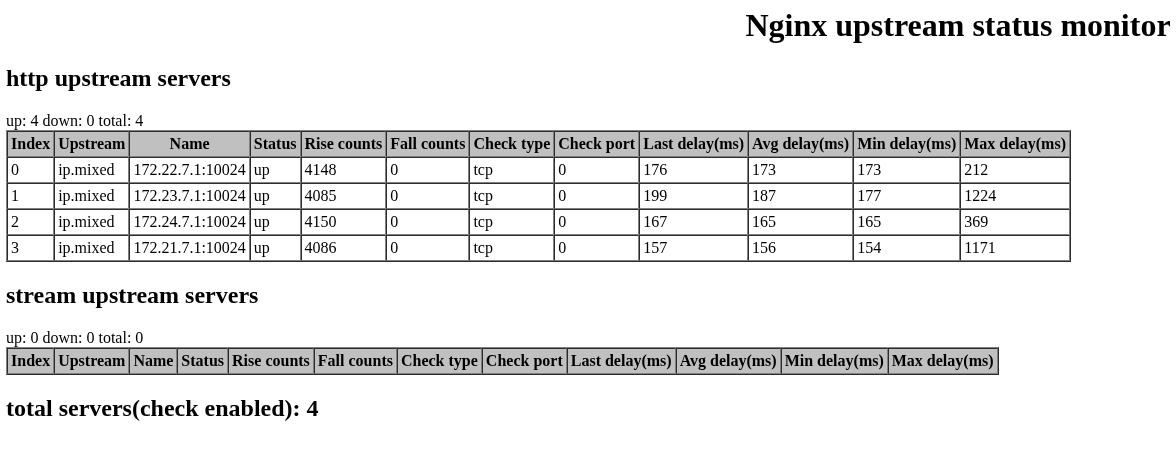

当前维护版本支持
HTTP upstream 健康检查
Stream upstream 健康检查
TCP 检查
UDP 检查
HTML、CSV、JSON、Prometheus 状态输出
上游检查延迟统计
TCP 检查连接复用
TCP keepalive 探测
它不再支持原项目里的 HTTP/FastCGI/MySQL/AJP/SSL hello 等七层检查类型
编译安装
如果是使用的Debian系统,可以直接使用已经编译好的源通过apt安装
首先你需要下载nginx的源码, 你可以从 GitHub 或 Nginx官网 上下载源码
项目仓库中有一个 build.sh 脚本, 里面有从nginx官方源码编译的方式, 你可以参照脚本内的方式编译出nginx的二进制可执行文件, 直接替换掉系统已安装的nginx的二进制可执行文件, 如果不知道当前系统的nginx命令文件的位置, 可以使用 which nginx 命令查询
当然也可以使用下面这个方式, 通过git库直接编译安装(下面这个configure中的参数并不全, 如果想要全部的默认参数看build.sh脚本)
git clone https://github.com/nginx/nginx.git
git clone https://github.com/Akvicor/nginx-healthcheck-module.git

cd nginx
git checkout release-1.26.3
git apply ../nginx-healthcheck-module/nginx_healthcheck_for_nginx_1.26+.patch

./auto/configure --with-stream --add-module=../nginx-healthcheck-module
make
make install
补丁的作用是把健康检查结果接入 Nginx upstream peer 选择逻辑中。也就是说,模块不是只提供一个状态页面,而是真的会影响 round robin、hash、consistent hash、least_conn 等 upstream 负载均衡路径,让 down 状态的 peer 不再被选中。
完整配置示例
worker_processes auto;

events {
    worker_connections 1024;
}

http {
    check_shm_size 2m;

    server {
        listen 8080;

        location /status {
            healthcheck_status json;
        }

        location / {
            proxy_pass http://web_backends;
        }
    }

    upstream web_backends {
        server 127.0.0.1:8081;
        server 127.0.0.2:8081;

        check interval=3000 rise=2 fall=5 timeout=1000 default_down=true type=tcp;
    }
}

stream {
    check_shm_size 2m;

    upstream tcp_backends {
        server 127.0.0.1:22;
        server 192.0.2.10:22;

        check interval=1000 timeout=900 type=tcp reuse=30s keepalive=30s:5s:1s:3;
    }

    server {
        listen 5222;
        proxy_pass tcp_backends;
    }

    upstream udp_backends {
        server 127.0.0.1:53;
        server 8.8.8.8:53;

        check interval=3000 rise=2 fall=5 timeout=1000 default_down=true type=udp;
    }

    server {
        listen 5353 udp;
        proxy_pass udp_backends;
    }
}
首先是 check_shm_size 用于设置保存健康检查状态的共享内存大小。如果检查的 upstream server 数量很多,可以调大该值。
check_shm_size size;最关键的是 upstream 里的 check 指令
check interval=3000 rise=2 fall=5 timeout=5000 default_down=true type=tcp;这表示每 3000ms 检查一次,单次检查超时为 5000ms。连续 2 次成功后标记为 up,连续 5 次失败后标记为 down。default_down=true 表示 Nginx 启动后 peer 默认先处于 down,等主动检查成功后再进入可用状态。
完整指令
check interval=milliseconds [fall=count] [rise=count] [timeout=milliseconds]
      [default_down=true|false] [type=tcp|udp] [port=check_port]
      [reuse=off|on|time] [keepalive=off|on|rehandshake[:idle[:intvl[:cnt]]]]
参数省略时默认值:
interval=5000 fall=3 rise=2 default_down=false type=tcp reuse=off keepalive=off。
省略 timeout 时取 min(5000, interval - interval / 10),使用整数除法;默认 interval 下为 4500ms。默认值和关联参数的校验在整条指令解析完成后计算,与参数顺序无关。check 至少需要一个参数,例如 check type=tcp; 使用其余默认值。
参数说明
interval:同一后端相邻两轮探测开始时刻的间隔,单位毫秒,最小100。轮次保持串行:上一轮结果提交后才能开始下一轮;如果上一轮超过 interval,结果提交后启动下一轮,不再额外等待一个完整 interval。fall:连续失败达到该次数后,后端被标记为 down。rise:连续成功达到该次数后,后端被标记为 up。timeout:单次检查超时时间,单位毫秒,必须为正数且小于 interval。5000ms 上限仅作用于默认值,显式值可以更大。UDP 的准备、发送和接收共用整轮固定预算。default_down:初始主动检查状态,TCP 和 UDP 均默认false,即新启动或新增的后端初始视为 up;true表示初始为 down,直到 rise 达标。reload 时身份匹配的后端继承旧状态。type:检查协议,只支持tcp或udp。port:可选检查端口,范围1~65535;省略时使用 upstream server 的端口。unix socket server 没有端口,配置 port 时nginx -t报错。reuse:保留 TCP 检查连接并定期重新握手。keepalive 同时关闭时,off每轮新建并关闭连接;on使用默认重新握手间隔max(30s, 2 × interval)。时间值设置自定义间隔,必须大于 interval;裸数字按秒计,支持30s、5m等 Nginx 秒级时间单位。keepalive:保留 TCP 检查连接,并让内核探测对端。格式为rehandshake:idle:intvl:cnt,相比 Nginx 的so_keepalive=idle:intvl:cnt,首位增加了重新握手间隔。后面的字段可以省略,空位使用模块默认值:keepalive=on使用全部模块默认值。首位也可以写on或留空,或者写off表示仅在连接断开后重连。裸时间值按秒计,cnt 为整数次数。idle 和 intvl 必须为1~32767的整秒,cnt 为1~127,且 intvl 不得大于 idle。
有限的重新握手间隔必须大于 interval,显式 idle 必须小于实际重新握手间隔。省略 idle 时,模块取“interval 向上取整到秒”和“小于实际重新握手间隔的最大整秒”的较小值,并以 32767 秒为上限;如果容不下正数 idle,配置报错。
三项内核参数均显式设置,空位不会使用操作系统的默认值。平台必须支持TCP_KEEPIDLE、TCP_KEEPINTVL、TCP_KEEPCNT,否则启用 keepalive 时nginx -t报错。Linux 支持这些选项,其他平台会拒绝该配置。
reuse 和 keepalive 只适用于 TCP,可以同时启用;实际重新握手间隔取 reuse 与 keepalive 首位中的较小值,off 视为无穷大。连接存活时间达到该值后,在下一轮检查中重建连接。该机制与业务请求使用的普通 upstream keepalive 相互独立。
# 每 1s 检查,健康期约每 5s 一个 keepalive 往返,连接存活 30s 后重新握手。
check interval=1000 timeout=900 type=tcp reuse=30s keepalive=30s:5s:1s:3;

# keepalive 首位 off 不贡献有限存活时间,由 reuse 控制重新握手。
check interval=1000 type=tcp reuse=30s keepalive=off:5s:1s:3;

# idle 省略时自动调小,确保早于重新握手发生。
check interval=1500 type=tcp reuse=2s keepalive=on;
keepalive 探测不带应用数据,由内核独立于检查轮次调度。每轮读取内核连接状态,不会强制发出探测,也不要求这一轮获得新的 ACK。在约 idle + intvl × cnt 都没有回应后(另加调度延迟),内核中止连接。cnt=3 时,前两个探测没有回应仍保留连接,第三个没有回应达到断开阈值。
检查连接断开本身不计失败。某一轮 peek 失败时,该轮立即重新握手,以新连接的结果计数;空闲期收到 FIN、RST 或 keepalive 超时则关闭旧连接,下一轮重新握手。这样可以避免仅因一条空闲连接过期,就把仍能正常接受新连接的上游判为不健康。
keepalive 能发现本地 peek 在重连前无法发现的主机或网络静默失联;重新握手还能检查是否能建立新连接。监听关闭或者防火墙只拦新连接时,已有连接仍可能正常;没有有限 reuse存活时间的 keepalive=off:... 无法验证新连接可用性。两种方式均只验证 TCP 层。
空闲期收到的服务端数据会被读掉并丢弃,连接继续保留;单条连接累计超过 4KB 时关闭。发送欢迎信息的服务也可能在应用握手超时后主动关闭连接,下一轮检查会重新握手。
TCP 检查会连接到后端并尝试 peek 一个字节。UDP 每轮使用独立 connected socket,向实际检查地址发送固定负载 NGX_UDP_CHECKER;实际发送失败、接收失败或成功读取的SO_ERROR 值用于识别错误。只有已尝试发送、仍有效且尚未截止的轮次观察到ECONNREFUSED 才计失败;空数据报、普通回复、无确认失败的静默截止和本机资源异常等终结结果计成功。这里的成功表示“本轮未确认失败”,不能证明应用服务健康。EAGAIN/EINTR 在原截止内等待或有界重试,发送成功后每轮只发送一个数据报。
失败使 fall 递增并清零 rise,成功使 rise 递增并清零 fall,达到相应阈值才转换状态。普通 socket 错误反馈受内核和网络条件影响;端口复用后迟到错误的网络关联能力有限。
TCP 和 UDP 检查语义
TCP 检查会尝试连接 upstream peer。连接成功并且 socket 状态符合预期时,peer 被认为健康;连接失败、超时或 socket 错误会推动 fall 计数增长。
UDP 检查的语义和 TCP 不一样。UDP 没有连接建立过程,模块会发送一段默认 payload,通过接收路径检测 ICMP 错误。如果超时但没有收到 ICMP 错误,当前实现会按成功处理。这一点很重要:UDP 检查更适合发现明确的端口不可达等错误,不等价于完整的应用层协议检查。
TCP复用
默认情况下,TCP 检查连接不会复用。每次检查结束后,连接都会关闭。每一轮检查都会重新和上游建立 TCP 连接。
如果显式配置 reuse=on,模块会复用健康检查连接:
check interval=3000 rise=2 fall=5 timeout=1000 default_down=true type=tcp reuse=on;
check_keepalive_requests 10; # 非必须,省略这行插件会使用默认值10
check_keepalive_requests 控制单条复用连接最多执行多少次检查,默认值是 10。达到次数后,连接会关闭并在后续检查中重新建立。
开启 reuse 后,需要理解一个行为差异:
第一次没有可复用连接时,模块会真正向上游发起 TCP connect。
后续复用同一条连接时,模块不再每轮新建 TCP 连接,而是在保存的 socket 上执行
recv(..., MSG_PEEK)。如果 socket 仍可读,或者返回
EAGAIN,模块认为这条内核维护的连接仍然健康。如果 peer 关闭连接、socket 出错、检查超时或达到复用次数,连接会被关闭,后续再重新建立。
因此reuse=on 更适合希望降低健康检查连接开销的场景(例如降低流量消耗)。它验证的是既有 TCP 连接是否仍然正常,而不是每个检查周期都验证“新建连接是否成功”。如果你希望每一轮都强制执行一次新的 TCP connect,就保持默认的 reuse=off。
当开启 TCP reuse 且 worker 数量大于 1 时,peer 会按 peer_index % worker_processes 分配给特定 worker 检查。这样可以把健康检查连接数量控制在接近 peer 数,而不是 peer 数 * worker_processes。
状态接口和延迟统计
模块提供 healthcheck_status 指令暴露状态接口:
location /status {
    healthcheck_status;
}

location /json {
    healthcheck_status json;
}

location /metrics {
    healthcheck_status prometheus;
}
也可以通过 query 参数切换格式:
/status?format=html
/status?format=csv
/status?format=json
/status?format=prometheus
/status?format=json&status=down
/status?format=json&status=up
JSON 输出会按 http 和 stream 分类展示 peer 状态,典型字段包括:
{
  "index": 0,
  "upstream": "web_backends",
  "name": "127.0.0.1:8081",
  "status": "up",
  "rise": 2,
  "fall": 0,
  "type": "tcp",
  "port": 0,
  "last_delay_ms": 1,
  "avg_delay_ms": 1,
  "min_delay_ms": 1,
  "max_delay_ms": 2
}
这里的延迟字段来自健康检查本身
last_delay_ms:最近一次成功检查耗时。avg_delay_ms:成功检查平均耗时。min_delay_ms:成功检查最小耗时。max_delay_ms:成功检查最大耗时。
这些字段对于排查后端抖动很有用。健康状态只告诉你 up 或 down,延迟统计可以进一步暴露“还能连上,但连接变慢”的问题。
Prometheus 输出则更适合接入监控系统,当前包含总数、up/down 数量、generation,以及每个 peer 的 rise、fall、active 指标。
配置建议
如果你是第一次接入,可以从保守配置开始:
check interval=3000 rise=2 fall=5 timeout=1000 default_down=true type=tcp;default_down=true更适合生产环境,避免 Nginx 启动后把尚未检查成功的后端直接纳入流量。rise不要设得太低,否则短暂成功可能导致不稳定后端过快回到流量路径。fall不要设得太低,否则偶发网络抖动可能导致后端频繁上下线。timeout应该小于业务可接受的失败等待时间。后端数量很多时,调大
check_shm_size。如果健康检查连接数压力明显,或者健康检查消耗流量过多,再考虑
type=tcp reuse=on。UDP 检查不要当作应用层协议健康检查,它只表达当前模块实现下的 UDP/socket 可达性判断。